


API web scraping cho dữ liệu sạch
Gửi mọi URL. Nhận lại Markdown hoặc JSON sạch, sẵn sàng cho ứng dụng hoặc AI agent của bạn.
Kéo qua trang để xem phần văn bản sạch mà Spicrawl giữ lại.
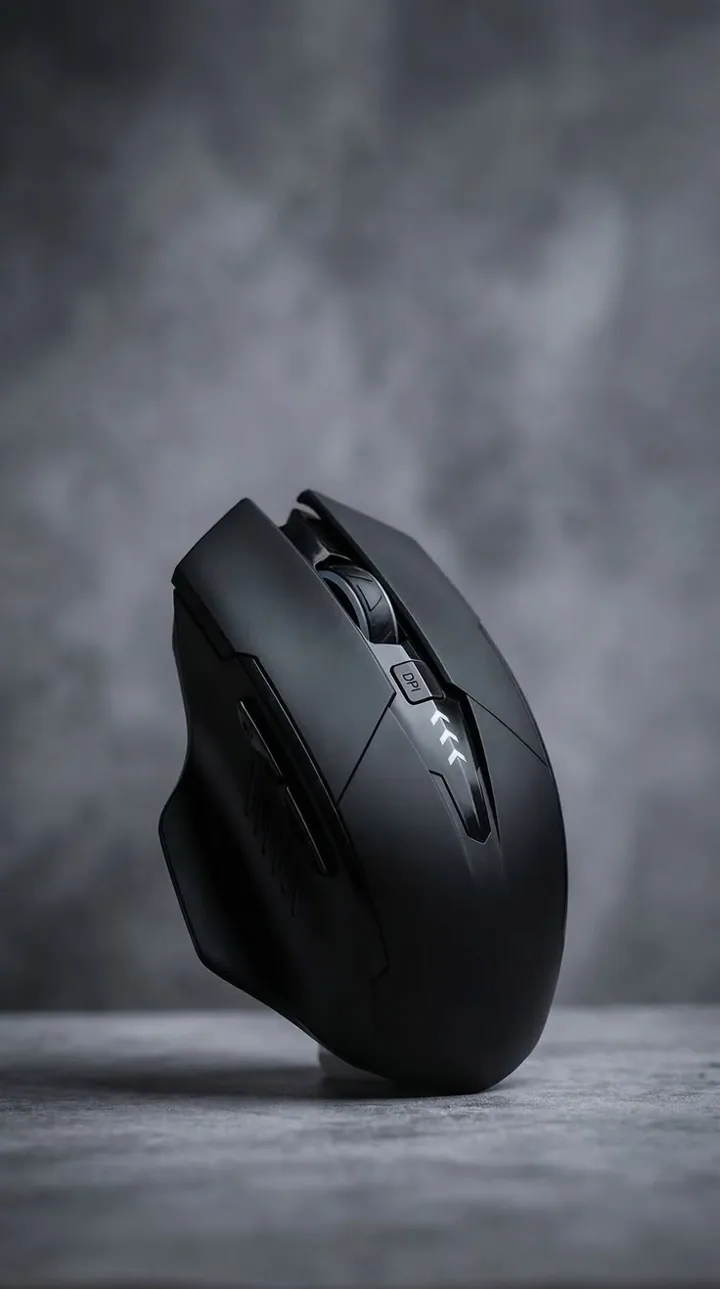
Bộ thu 2.4 GHz độ trễ thấp, pin 70 ngày và công tắc im lặng. Dành cho những ngày làm việc dài.
| Kết nối | 2.4 GHz, BT5 |
| Pin | 70 ngày |
| Trọng số | 62 g |
Chỉ giữ nội dung chính
Spicrawl bỏ banner cookie, menu, quảng cáo và chân trang, và giữ nội dung chính.
curl -X POST https://api.spicrawl.com/v1/scrape \ -H "Authorization: Bearer spicrawl_live_…" \ -H "Content-Type: application/json" \ -d '{ "url": "https://example.com/product/1", "response_format": "markdown", "main_content_only": true }'Cách hoạt động
- Gửi một URL tới
POST /v1/scrapevà chọn mộtresponse_format. - Spicrawl fetch trang. Nó dùng request thường trước, hoặc dùng trình duyệt khi bạn yêu cầu.
- Bạn nhận được kết quả trong response body, kèm status của chính site trong một header.
curl -sS -D - https://api.spicrawl.com/v1/scrape \
  -H "Authorization: Bearer $SPICRAWL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://example.com/products/42", "response_format": "markdown"}'
import os, requests
r = requests.post(
"https://api.spicrawl.com/v1/scrape",
headers={"Authorization": f"Bearer {os.environ['SPICRAWL_API_KEY']}"},
json={"url": "https://example.com/products/42", "response_format": "markdown"},
timeout=120,
)
print("site status:", r.headers.get("X-Target-Status"))
print(r.text)const r = await fetch("https://api.spicrawl.com/v1/scrape", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.SPICRAWL_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({ url: "https://example.com/products/42", response_format: "markdown" }),
});
console.log("site status:", r.headers.get("X-Target-Status"));
console.log(await r.text());spicrawl scrape https://example.com/products/42 --format markdown --metaHãy giữ key trong SPICRAWL_API_KEY và đừng bao giờ ghi nó vào code bạn commit.
Định dạng đầu ra
| Định dạng | Phù hợp nhất cho |
|---|---|
markdown | Prompt AI, RAG và đọc hiểu. Mặc định chỉ lấy nội dung chính. |
json | Ứng dụng: nội dung cùng metadata, liên kết hoặc các trường đã trích xuất trong một object. |
html | Khi bạn cần markup của trang. Đây là mặc định. |
text | Đầu ra nhỏ nhất, không có định dạng. |
pdf | Một PDF của trang đã render. |
Xem trang web sang Markdown để biết thêm về đầu ra Markdown.
Kiểm tra kết quả
HTTP status là của Spicrawl. Những gì site đã trả lời nằm trong X-Target-Status. Một lệnh gọi thành công trông như sau:
HTTP/2 200
content-type: text/markdown; charset=utf-8
x-target-status: 200
x-engine: fetch
x-credits-charged: 1
cache-state: miss
Mã 403 hoặc 503 trong X-Target-Status nghĩa là bạn nhận được một trang chặn, và nó tốn 0 credit.
Các trang cần nhiều hơn
- Trang JavaScript. Đặt
js_render: trueđể tải trang trong trình duyệt trước. Xem Render JavaScript. - Trang cần đăng nhập. Hãy dùng session để giữ cookie giữa các request, cho các tài khoản bạn sở hữu hoặc được phép sử dụng. Xem session và đăng nhập.
- Click và cuộn. Hành động trình duyệt có thể nhấp, gõ và cuộn trước khi trang được đọc. Xem hành động trên trình duyệt.
- Nhiều URL. Một batch job nhận tới 10,000 URL trong một lệnh gọi. Xem batch.
Nó tốn bao nhiêu
- Miễn phí trong thời gian beta, không cần thẻ tín dụng.
- Credit cho mỗi request thành công: 1 cho request thường, 3 cho render JavaScript, 8 cho render bằng trình duyệt đầy đủ.
- Thất bại là miễn phí: lỗi, thử thách bot và trang trả về lỗi đều tốn 0.
- Giới hạn mọi request bằng
max_cost, để một lệnh gọi không bao giờ tốn nhiều hơn bạn dự kiến.
Nên biết
- Không crawl. Spicrawl không đi theo liên kết hay tự khám phá trang. Bạn gửi các URL.
- Sắp ra mắt: proxy được quản lý, chế độ stealth, trình duyệt từ xa và trích xuất từ một prompt bằng ngôn ngữ thường. Hiện tại bạn có thể dùng proxy của riêng mình mà không tốn thêm.
- Trách nhiệm của bạn: chỉ lấy các trang bạn có quyền sử dụng. Xem điều khoản của chúng tôi.
Câu hỏi thường gặp
API web scraping là gì?
Đây là một dịch vụ lấy trang web giúp bạn và trả về nội dung của nó ở dạng code của bạn có thể dùng. Bạn gửi một URL; nó xử lý request, JavaScript và dọn dẹp, rồi trả về Markdown, JSON hoặc HTML.
API scraping của Spicrawl tốn bao nhiêu?
Nó miễn phí trong beta, không cần thẻ tín dụng. Request dùng credit: 1 cho request thường, 3 cho render JavaScript và 8 cho render bằng trình duyệt đầy đủ. Lỗi, bot challenge và trang trả về lỗi tốn 0.
Nó có scrape được các trang cần JavaScript không?
Có. Đặt js_render là true và trang tải trong trình duyệt trước. Hãy bắt đầu bằng một request thường và chỉ render khi kết quả thường bị trống.
Làm sao để biết trang web có chặn tôi không?
Hãy đọc header X-Target-Status. HTTP status là của Spicrawl; X-Target-Status là những gì site đã trả lời. Mã 403 hoặc 503 ở đó nghĩa là bạn nhận được một trang chặn, và nó tốn 0 credit.
Nó có crawl được cả một trang web không?
Không. Spicrawl không theo liên kết hay khám phá trang. Hãy gửi các URL bạn muốn, từng URL một hoặc tối đa 10,000 trong một lệnh batch.