


API веб-скрейпинга для чистых данных
Отправьте любой URL. Получите чистый Markdown или JSON, готовый для вашего приложения или ИИ-агента.
Проведите по странице, чтобы увидеть чистый текст, который сохраняет Spicrawl.
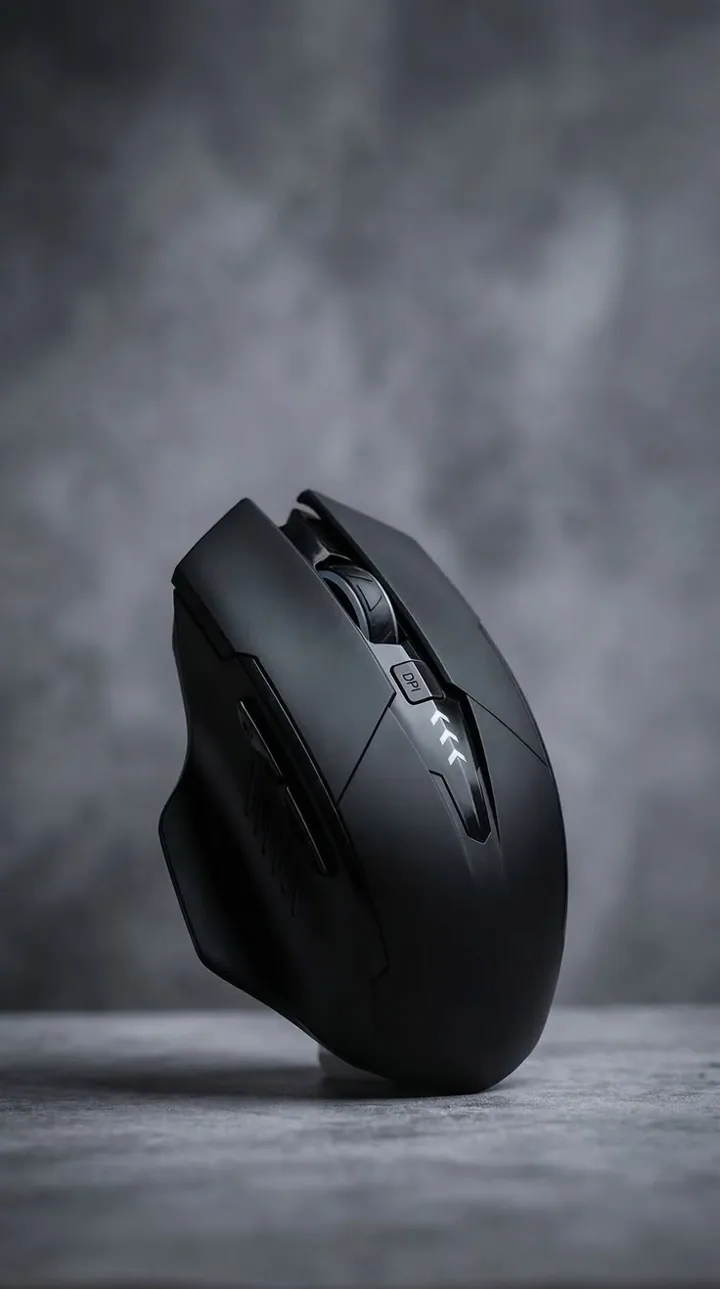
Приёмник 2.4 GHz с низкой задержкой, 70 дней работы от батареи и бесшумные переключатели. Создана для долгих дней.
| Подключение | 2.4 GHz, BT5 |
| Батарея | 70 дней |
| Вес | 62 g |
Оставьте только основное содержимое
Spicrawl убирает баннер cookie, меню, рекламу и футер и сохраняет основное содержимое.
curl -X POST https://api.spicrawl.com/v1/scrape \ -H "Authorization: Bearer spicrawl_live_…" \ -H "Content-Type: application/json" \ -d '{ "url": "https://example.com/product/1", "response_format": "markdown", "main_content_only": true }'Как это работает
- Отправьте URL на
POST /v1/scrapeи выберитеresponse_format. - Spicrawl загружает страницу. Сначала используется обычный запрос или браузер, если вы его запросите.
- Вы получаете результат в теле ответа, а собственный статус сайта — в заголовке.
curl -sS -D - https://api.spicrawl.com/v1/scrape \
  -H "Authorization: Bearer $SPICRAWL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://example.com/products/42", "response_format": "markdown"}'
import os, requests
r = requests.post(
"https://api.spicrawl.com/v1/scrape",
headers={"Authorization": f"Bearer {os.environ['SPICRAWL_API_KEY']}"},
json={"url": "https://example.com/products/42", "response_format": "markdown"},
timeout=120,
)
print("site status:", r.headers.get("X-Target-Status"))
print(r.text)const r = await fetch("https://api.spicrawl.com/v1/scrape", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.SPICRAWL_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({ url: "https://example.com/products/42", response_format: "markdown" }),
});
console.log("site status:", r.headers.get("X-Target-Status"));
console.log(await r.text());spicrawl scrape https://example.com/products/42 --format markdown --metaХраните ключ в SPICRAWL_API_KEY и никогда не записывайте его в код, который коммитите.
Форматы вывода
| Формат | Лучше всего для |
|---|---|
markdown | Для промптов ИИ, RAG и чтения. По умолчанию только основное содержимое. |
json | Приложения: контент плюс метаданные, ссылки или извлечённые поля в одном объекте. |
html | Когда нужна разметка страницы. Это значение по умолчанию. |
text | Самый маленький вывод, без форматирования. |
pdf | PDF отрисованной страницы. |
Подробнее о выводе Markdown — в сайт в Markdown.
Проверьте результат
HTTP-статус принадлежит Spicrawl. То, что ответил сайт, находится в X-Target-Status. Успешный вызов выглядит так:
HTTP/2 200
content-type: text/markdown; charset=utf-8
x-target-status: 200
x-engine: fetch
x-credits-charged: 1
cache-state: miss
403 или 503 в X-Target-Status означает, что вы получили страницу блокировки, и она стоит 0 кредитов.
Страницы, которым нужно больше
- JavaScript-страницы. Задайте
js_render: true, чтобы сначала загрузить страницу в браузере. См. Рендеринг JavaScript. - Страницы с входом. Используйте сессию, чтобы сохранять cookies между запросами, для аккаунтов, которыми вы владеете или которыми вам разрешено пользоваться. См. сессии и входы.
- Клики и прокрутка. Действия в браузере могут кликать, вводить текст и прокручивать страницу перед чтением. См. действия в браузере.
- Много URL. Одно пакетное задание принимает до 10 000 URL за один вызов. См. batch.
Сколько это стоит
- Бесплатно в бета-версии, без банковской карты.
- Кредитов за успешный запрос: 1 за обычный запрос, 3 за рендеринг JavaScript, 8 за полный рендеринг в браузере.
- Сбои бесплатны: ошибки, проверки на бота и страницы, отвечающие ошибкой, стоят 0.
- Ограничьте каждый запрос с помощью
max_cost, чтобы вызов никогда не стоил больше, чем вы ожидаете.
Полезно знать
- Без обхода. Spicrawl не переходит по ссылкам и не находит страницы. URL отправляете вы.
- Скоро: управляемые прокси, режим stealth, удалённый браузер и извлечение данных по запросу на обычном языке. Сейчас можно подключить собственный прокси без доплаты.
- Ваша ответственность: загружайте только страницы, которые вы вправе использовать. См. наши условия.
Часто задаваемые вопросы
Что такое API веб-скрейпинга?
Это сервис, который загружает веб-страницу за вас и возвращает её содержимое в виде, пригодном для вашего кода. Вы отправляете URL; он обрабатывает запрос, JavaScript и очистку и возвращает Markdown, JSON или HTML.
Сколько стоит API веб-скрейпинга Spicrawl?
Он бесплатен в бета-версии, без банковской карты. Запросы расходуют кредиты: 1 за обычный запрос, 3 за рендеринг JavaScript и 8 за рендеринг в полноценном браузере. Ошибки, проверки на бота и страницы, отвечающие ошибкой, стоят 0.
Может ли он скрейпить страницы, которым нужен JavaScript?
Да. Задайте js_render в true, и страница сначала загрузится в браузере. Начните с обычного запроса и рендерите, только когда обычный результат пуст.
Как понять, что сайт меня заблокировал?
Читайте заголовок X-Target-Status. HTTP-статус принадлежит Spicrawl; X-Target-Status — это то, что ответил сайт. Значение 403 или 503 означает, что вы получили страницу блокировки, и она стоит 0 кредитов.
Может ли он обойти весь сайт?
Нет. Spicrawl не переходит по ссылкам и не находит страницы. Отправляйте нужные URL, по одному или до 10,000 за один пакетный вызов.