


Web scraping-API voor schone data
Stuur elke URL. Krijg schone Markdown of JSON terug, klaar voor je app of AI-agent.
Sleep over de pagina om de schone tekst te zien die Spicrawl bewaart.
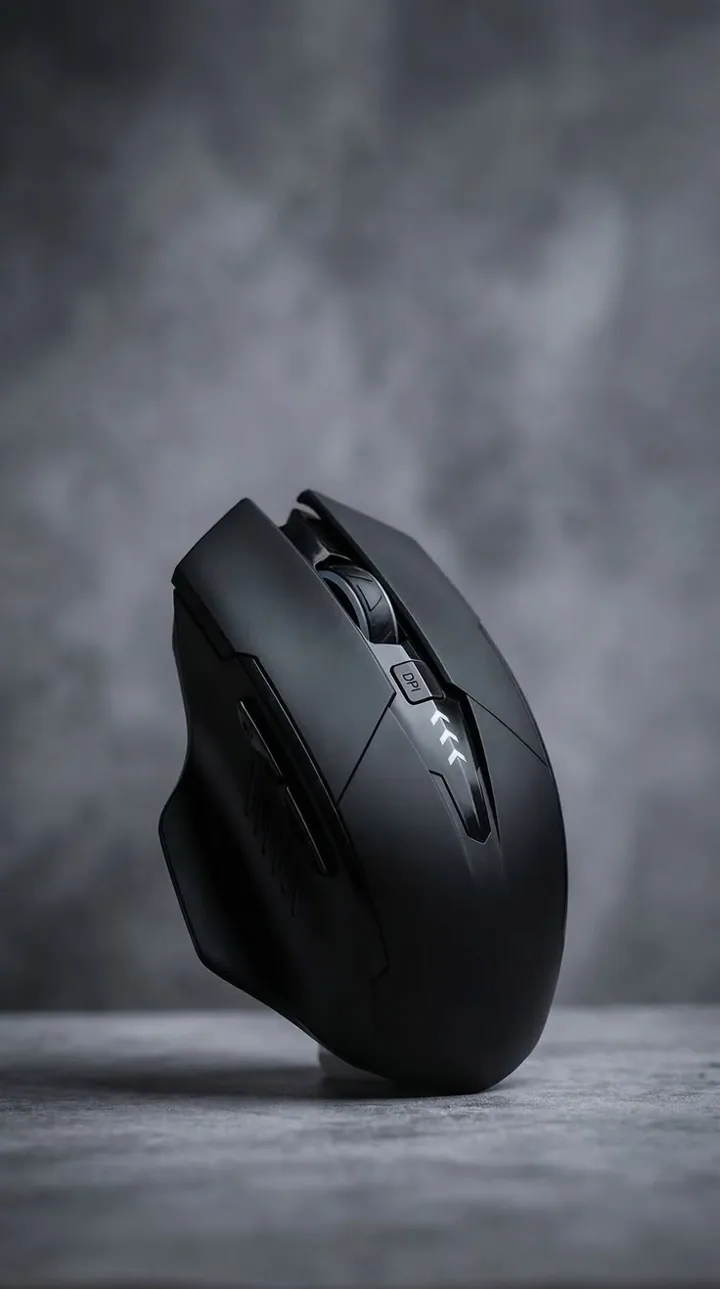
Ontvanger met lage latency op 2.4 GHz, 70 dagen batterijduur en stille schakelaars. Gemaakt voor lange dagen.
| Verbinding | 2.4 GHz, BT5 |
| Batterij | 70 dagen |
| Gewicht | 62 g |
Houd alleen de hoofdinhoud
Spicrawl laat de cookiebanner, menu's, advertenties en footer weg en bewaart de hoofdinhoud.
curl -X POST https://api.spicrawl.com/v1/scrape \ -H "Authorization: Bearer spicrawl_live_…" \ -H "Content-Type: application/json" \ -d '{ "url": "https://example.com/product/1", "response_format": "markdown", "main_content_only": true }'Hoe het werkt
- Stuur een URL naar
POST /v1/scrapeen kies eenresponse_format. - Spicrawl haalt de pagina op. Het gebruikt eerst een gewoon verzoek, of een browser als je erom vraagt.
- Je krijgt het resultaat in de response body, met de eigen status van de site in een header.
curl -sS -D - https://api.spicrawl.com/v1/scrape \
  -H "Authorization: Bearer $SPICRAWL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://example.com/products/42", "response_format": "markdown"}'
import os, requests
r = requests.post(
"https://api.spicrawl.com/v1/scrape",
headers={"Authorization": f"Bearer {os.environ['SPICRAWL_API_KEY']}"},
json={"url": "https://example.com/products/42", "response_format": "markdown"},
timeout=120,
)
print("site status:", r.headers.get("X-Target-Status"))
print(r.text)const r = await fetch("https://api.spicrawl.com/v1/scrape", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.SPICRAWL_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({ url: "https://example.com/products/42", response_format: "markdown" }),
});
console.log("site status:", r.headers.get("X-Target-Status"));
console.log(await r.text());spicrawl scrape https://example.com/products/42 --format markdown --metaBewaar je sleutel in SPICRAWL_API_KEY en schrijf hem nooit in code die je commit.
Uitvoerformaten
| Formaat | Het best voor |
|---|---|
markdown | AI-prompts, RAG en lezen. Standaard alleen de hoofdinhoud. |
json | Apps: de inhoud plus metadata, links of geëxtraheerde velden in één object. |
html | Als je de markup van de pagina nodig hebt. Dit is de standaard. |
text | De kleinste uitvoer, zonder opmaak. |
pdf | Een PDF van de gerenderde pagina. |
Zie website naar Markdown voor meer over de Markdown-uitvoer.
Controleer het resultaat
De HTTP-status is die van Spicrawl. Wat de site antwoordde staat in X-Target-Status. Een geslaagde aanroep ziet er zo uit:
HTTP/2 200
content-type: text/markdown; charset=utf-8
x-target-status: 200
x-engine: fetch
x-credits-charged: 1
cache-state: miss
Een 403 of 503 in X-Target-Status betekent dat je een blokpagina kreeg, en dat kost 0 credits.
Pagina's die meer nodig hebben
- JavaScript-pagina's. Stel
js_render: truein om de pagina eerst in een browser te laden. Zie JavaScript-rendering. - Pagina's achter een login. Gebruik een sessie om cookies tussen verzoeken te bewaren, voor accounts die van jou zijn of die je mag gebruiken. Zie sessies en logins.
- Klikken en scrollen. Browseracties kunnen klikken, typen en scrollen voordat de pagina wordt gelezen. Zie browseracties.
- Veel URL's. Een batchjob accepteert tot 10.000 URL's in één aanroep. Zie batch.
Wat het kost
- Gratis tijdens de beta, zonder creditcard.
- Credits per geslaagd verzoek: 1 voor een gewoon verzoek, 3 voor JavaScript-rendering, 8 voor full-browser-rendering.
- Mislukkingen zijn gratis: fouten, botchallenges en pagina's die met een fout antwoorden kosten 0.
- Begrens elk verzoek met
max_cost, zodat een aanroep nooit meer kost dan je verwacht.
Goed om te weten
- Geen crawling. Spicrawl volgt geen links en ontdekt geen pagina's. Jij stuurt de URL's.
- Binnenkort: beheerde proxy's, stealth-modus, een remote browser en extractie op basis van een prompt in gewone taal. Nu kun je zonder extra kosten je eigen proxy meenemen.
- Jouw verantwoordelijkheid: haal alleen pagina's op die je mag gebruiken. Zie onze voorwaarden.
Veelgestelde vragen
Wat is een web scraping-API?
Het is een dienst die een webpagina voor je ophaalt en de inhoud teruggeeft in een vorm die je code kan gebruiken. Je stuurt een URL; de dienst regelt het verzoek, de JavaScript en het opschonen, en geeft Markdown, JSON of HTML terug.
Wat kost de Spicrawl scraping-API?
Het is gratis tijdens de beta, zonder creditcard. Verzoeken gebruiken credits: 1 voor een gewoon verzoek, 3 voor JavaScript-rendering en 8 voor volledige browserrendering. Fouten, botchallenges en pagina's die met een fout antwoorden kosten 0.
Kan het pagina's scrapen die JavaScript nodig hebben?
Ja. Stel js_render in op true en de pagina wordt eerst in een browser geladen. Begin met een gewoon verzoek en render alleen als het gewone resultaat leeg is.
Hoe weet ik of de site me heeft geblokkeerd?
Lees de header X-Target-Status. De HTTP-status is die van Spicrawl; X-Target-Status is wat de site antwoordde. Een 403 of 503 daar betekent dat je een blokpagina kreeg, en dat kost 0 credits.
Kan het een hele website crawlen?
Nee. Spicrawl volgt geen links en ontdekt geen pagina's. Stuur de URL's die je wilt, één voor één of tot 10.000 in één batchaanroep.