


깔끔한 데이터를 위한 웹 스크래핑 API
아무 URL이나 보내세요. 앱이나 AI 에이전트에서 바로 쓸 수 있는 깔끔한 Markdown 또는 JSON을 돌려받습니다.
페이지 위를 드래그해서 Spicrawl이 남기는 깔끔한 텍스트를 확인하세요.
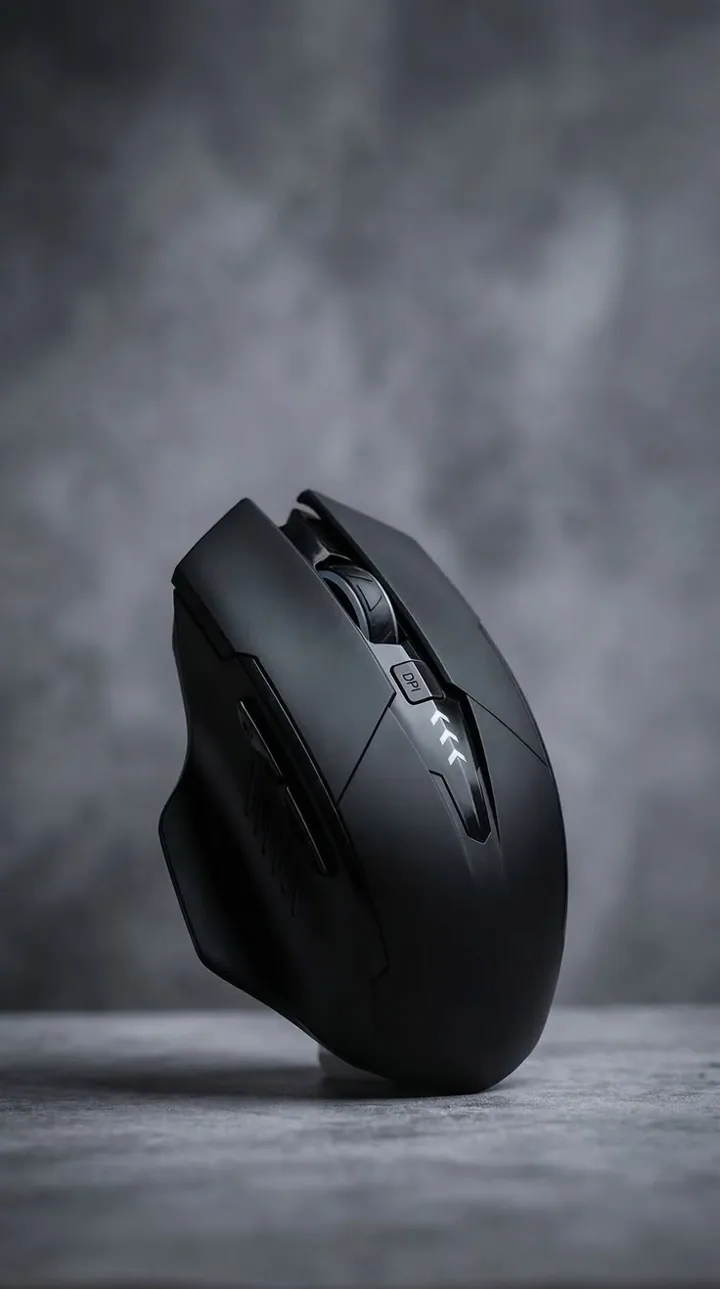
저지연 2.4 GHz 수신기, 70일 배터리 수명, 무소음 스위치. 긴 하루를 위해 만들었습니다.
| 연결 | 2.4 GHz, BT5 |
| 배터리 | 70일 |
| 무게 | 62 g |
본문만 남기기
Spicrawl은 쿠키 배너, 메뉴, 광고, 푸터를 제거하고 본문을 유지합니다.
curl -X POST https://api.spicrawl.com/v1/scrape \ -H "Authorization: Bearer spicrawl_live_…" \ -H "Content-Type: application/json" \ -d '{ "url": "https://example.com/product/1", "response_format": "markdown", "main_content_only": true }'작동 방식
- URL 보내기
POST /v1/scrape로 보내고response_format를 선택하세요. - Spicrawl이 페이지를 가져옵니다. 일반 요청을 먼저 사용하고, 요청하면 브라우저를 사용합니다.
- 결과를 받습니다 응답 본문에 담겨 오며, 사이트 자체의 상태는 헤더에 있습니다.
curl -sS -D - https://api.spicrawl.com/v1/scrape \
  -H "Authorization: Bearer $SPICRAWL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://example.com/products/42", "response_format": "markdown"}'
import os, requests
r = requests.post(
"https://api.spicrawl.com/v1/scrape",
headers={"Authorization": f"Bearer {os.environ['SPICRAWL_API_KEY']}"},
json={"url": "https://example.com/products/42", "response_format": "markdown"},
timeout=120,
)
print("site status:", r.headers.get("X-Target-Status"))
print(r.text)const r = await fetch("https://api.spicrawl.com/v1/scrape", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.SPICRAWL_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({ url: "https://example.com/products/42", response_format: "markdown" }),
});
console.log("site status:", r.headers.get("X-Target-Status"));
console.log(await r.text());spicrawl scrape https://example.com/products/42 --format markdown --meta키는 SPICRAWL_API_KEY에 보관하고 커밋하는 코드에는 절대 쓰지 마세요.
출력 형식
| 형식 | 추천 용도 |
|---|---|
markdown | AI 프롬프트, RAG, 읽기용. 기본값은 본문만 반환합니다. |
json | 앱: 본문과 메타데이터, 링크 또는 추출한 필드를 하나의 객체로 제공합니다. |
html | 페이지의 마크업이 필요할 때. 기본값입니다. |
text | 서식이 없는 가장 작은 출력. |
pdf | 렌더링된 페이지의 PDF. |
Markdown 출력에 대한 자세한 내용은 웹사이트를 Markdown으로를 참고하세요.
결과 확인
HTTP 상태는 Spicrawl의 상태입니다. 사이트가 응답한 내용은 X-Target-Status에 있습니다. 호출이 성공하면 다음과 같습니다:
HTTP/2 200
content-type: text/markdown; charset=utf-8
x-target-status: 200
x-engine: fetch
x-credits-charged: 1
cache-state: missX-Target-Status의 403 또는 503은 차단 페이지를 받았다는 뜻이며 0 크레딧입니다.
더 많은 것이 필요한 페이지
- JavaScript 페이지. 먼저 브라우저에서 페이지를 로드하려면
js_render: true를 설정하세요. JavaScript 렌더링를 참고하세요. - 로그인이 필요한 페이지. 본인 소유이거나 사용 권한이 있는 계정에서 요청 사이에 쿠키를 유지하려면 세션을 사용하세요. 세션과 로그인를 참고하세요.
- 클릭과 스크롤. 브라우저 작업으로 페이지를 읽기 전에 클릭, 입력, 스크롤을 할 수 있습니다. 브라우저 작업를 참고하세요.
- 많은 URL. 배치 작업은 한 번의 호출로 최대 10,000개의 URL을 받습니다. batch를 참고하세요.
비용
- 베타 기간 무료, 신용카드 없이 사용할 수 있습니다.
- 성공한 요청당 크레딧: 일반 요청은 1, JavaScript 렌더링은 3, 전체 브라우저 렌더링은 8입니다.
- 실패는 무료입니다: 오류, 봇 챌린지, 오류로 응답하는 페이지는 0입니다.
- 모든 요청에 상한 설정
max_cost로 설정하면 호출 한 번이 예상보다 더 많은 비용이 들지 않습니다.
알아 두세요
- 크롤링은 지원하지 않습니다. Spicrawl은 링크를 따라가거나 페이지를 찾지 않습니다. URL을 직접 보내세요.
- 곧 제공 예정: 관리형 프록시, 스텔스 모드, 원격 브라우저, 일반 문장 프롬프트를 이용한 추출. 현재는 추가 비용 없이 직접 프록시를 사용할 수 있습니다.
- 사용자의 책임: 사용할 권리가 있는 페이지만 가져오세요. terms을 참고하세요.
자주 묻는 질문
웹 스크래핑 API란 무엇인가요?
웹 페이지를 대신 가져와 코드에서 쓸 수 있는 형태로 내용을 돌려주는 서비스입니다. URL을 보내면 요청, JavaScript, 정리를 처리하고 Markdown, JSON 또는 HTML을 반환합니다.
Spicrawl 스크래핑 API는 비용이 얼마인가요?
베타 기간 무료이며 신용카드가 필요하지 않습니다. 요청은 크레딧을 사용합니다. 일반 요청은 1, JavaScript 렌더링은 3, 풀 브라우저 렌더링은 8입니다. 오류, 봇 챌린지, 오류로 응답하는 페이지는 0입니다.
JavaScript가 필요한 페이지를 스크랩할 수 있나요?
예. js_render를 true로 설정하면 페이지가 먼저 브라우저에서 로드됩니다. 일반 요청으로 시작하고, 일반 결과가 비어 있을 때만 렌더링하세요.
사이트에 차단당했는지 어떻게 알 수 있나요?
X-Target-Status 헤더를 확인하세요. HTTP 상태는 Spicrawl의 상태이고, X-Target-Status는 사이트가 응답한 상태입니다. 여기서 403이나 503이 보이면 차단 페이지를 받았다는 뜻이며 0 크레딧입니다.
웹사이트 전체를 크롤할 수 있나요?
아니요. Spicrawl은 링크를 따라가거나 페이지를 찾아내지 않습니다. 원하는 URL을 하나씩 보내거나 배치 호출 한 번에 최대 10,000개까지 보내세요.