


クリーンなデータのためのウェブスクレイピング API
任意の URL を送ってください。アプリや AI エージェントにそのまま使える、クリーンな Markdown または JSON が返ります。
ページ上をドラッグすると、Spicrawl が残すクリーンなテキストを確認できます。
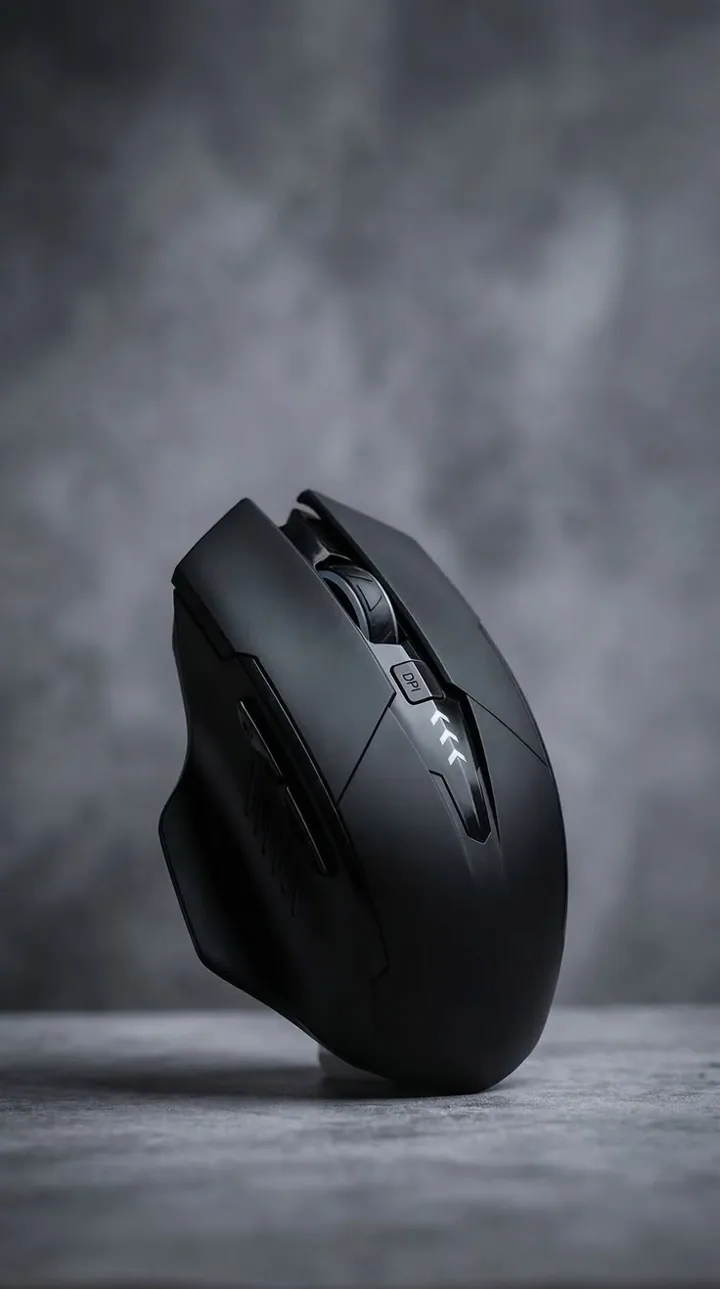
低遅延の 2.4 GHz レシーバー、70 日間持続するバッテリー、静音スイッチ。長時間の使用向けに設計されています。
| 接続 | 2.4 GHz, BT5 |
| バッテリー | 70 日 |
| 重み | 62 g |
本文だけを残す
Spicrawl は、Cookie バナー、メニュー、広告、フッターを取り除き、本文を残します。
curl -X POST https://api.spicrawl.com/v1/scrape \ -H "Authorization: Bearer spicrawl_live_…" \ -H "Content-Type: application/json" \ -d '{ "url": "https://example.com/product/1", "response_format": "markdown", "main_content_only": true }'仕組み
- URL を送る
POST /v1/scrapeに送り、response_formatを選びます。 - Spicrawl はページを取得します。 まず通常のリクエストを使い、ブラウザを指定した場合はブラウザを使います。
- 結果が得られます レスポンスボディに入っており、サイト自身のステータスはヘッダーにあります。
curl -sS -D - https://api.spicrawl.com/v1/scrape \
  -H "Authorization: Bearer $SPICRAWL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://example.com/products/42", "response_format": "markdown"}'
import os, requests
r = requests.post(
"https://api.spicrawl.com/v1/scrape",
headers={"Authorization": f"Bearer {os.environ['SPICRAWL_API_KEY']}"},
json={"url": "https://example.com/products/42", "response_format": "markdown"},
timeout=120,
)
print("site status:", r.headers.get("X-Target-Status"))
print(r.text)const r = await fetch("https://api.spicrawl.com/v1/scrape", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.SPICRAWL_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({ url: "https://example.com/products/42", response_format: "markdown" }),
});
console.log("site status:", r.headers.get("X-Target-Status"));
console.log(await r.text());spicrawl scrape https://example.com/products/42 --format markdown --metaキーは SPICRAWL_API_KEY に保管し、コミットするコードには書き込まないでください。
出力形式
| 形式 | おすすめの用途 |
|---|---|
markdown | AI プロンプト、RAG、閲覧向け。デフォルトでは本文のみ。 |
json | アプリ向け: コンテンツに加え、メタデータ、リンク、抽出したフィールドを 1 つのオブジェクトで返します。 |
html | ページのマークアップが必要なとき。これがデフォルトです。 |
text | フォーマットなしの、最小の出力。 |
pdf | レンダリングされたページの PDF。 |
Markdown 出力の詳細は ウェブサイトから Markdown へ を参照してください。
結果を確認する
HTTP ステータスは Spicrawl のものです。サイトが返した内容は X-Target-Status にあります。成功した呼び出しは次のようになります:
HTTP/2 200
content-type: text/markdown; charset=utf-8
x-target-status: 200
x-engine: fetch
x-credits-charged: 1
cache-state: miss
X-Target-Status の 403 または 503 は、ブロックページが返ったことを意味し、0 クレジットです。
さらに必要なページ
- JavaScript ページ。
js_render: trueを設定すると、まずブラウザでページを読み込みます。JavaScript レンダリング を参照してください。 - ログインが必要なページ。 セッションで、リクエスト間で Cookie を保持します。ご自身が所有する、または利用が認められているアカウント向けです。セッションとログイン を参照してください。
- クリックとスクロール。 ブラウザアクションで、ページを読む前にクリック、入力、スクロールができます。ブラウザアクション を参照してください。
- 多数の URL。 バッチジョブは 1 回の呼び出しで最大 10,000 件の URL を受け付けます。batch を参照してください。
料金
- ベータ期間中は無料、 クレジットカードも不要です。
- 成功したリクエストごとのクレジット: 通常のリクエストは 1、JavaScript レンダリングは 3、フルブラウザレンダリングは 8。
- 失敗は無料です: エラー、ボットチャレンジ、エラーで応答するページは 0 です。
- すべてのリクエストに上限を設ける
max_costを付けて、1 回の呼び出しでも想定を超える料金がかからないようにします。
知っておくべきこと
- クロールはありません。 Spicrawl はリンクをたどったり、ページを探したりしません。URL はお客様が送ります。
- 近日公開: マネージドプロキシ、ステルスモード、リモートブラウザ、自然な言葉で書いたプロンプトからの抽出。現時点では、ご自身のプロキシを追加料金なしで使えます。
- あなたの責任: 利用する権利のあるページのみを取得してください。terms を参照してください。
よくある質問
ウェブスクレイピング API とは何ですか?
ウェブページを代わりに取得し、コードで使える形でその内容を返すサービスです。URL を送ると、リクエスト、JavaScript、クリーンアップを処理し、Markdown、JSON、HTML を返します。
Spicrawl スクレイピング API の料金はいくらですか?
ベータ期間中は無料で、クレジットカードは不要です。リクエストはクレジットを使います。通常のリクエストは 1、JavaScript レンダリングは 3、フルブラウザレンダリングは 8 です。エラー、ボットチャレンジ、エラーで応答するページは 0 です。
JavaScript が必要なページをスクレイプできますか?
はい。js_render を true に設定すると、ページはまずブラウザで読み込まれます。通常のリクエストから始め、通常の結果が空のときだけレンダリングしてください。
サイトにブロックされたかどうかはどうすればわかりますか?
X-Target-Status ヘッダーを確認してください。HTTP ステータスは Spicrawl のもので、X-Target-Status はサイトが返した内容です。そこに 403 または 503 があれば、ブロックページが返ったことを意味し、0 クレジットです。
ウェブサイト全体をクロールできますか?
いいえ。Spicrawl はリンクをたどったり、ページを探したりしません。ほしい URL を、一件ずつ、またはバッチ呼び出し 1 回で最大 10,000 件まで送ってください。