


API de web scraping para dados limpos
Envie qualquer URL. Receba Markdown ou JSON limpo de volta, pronto para o seu app ou agente de IA.
Arraste sobre a página para ver o texto limpo que o Spicrawl mantém.
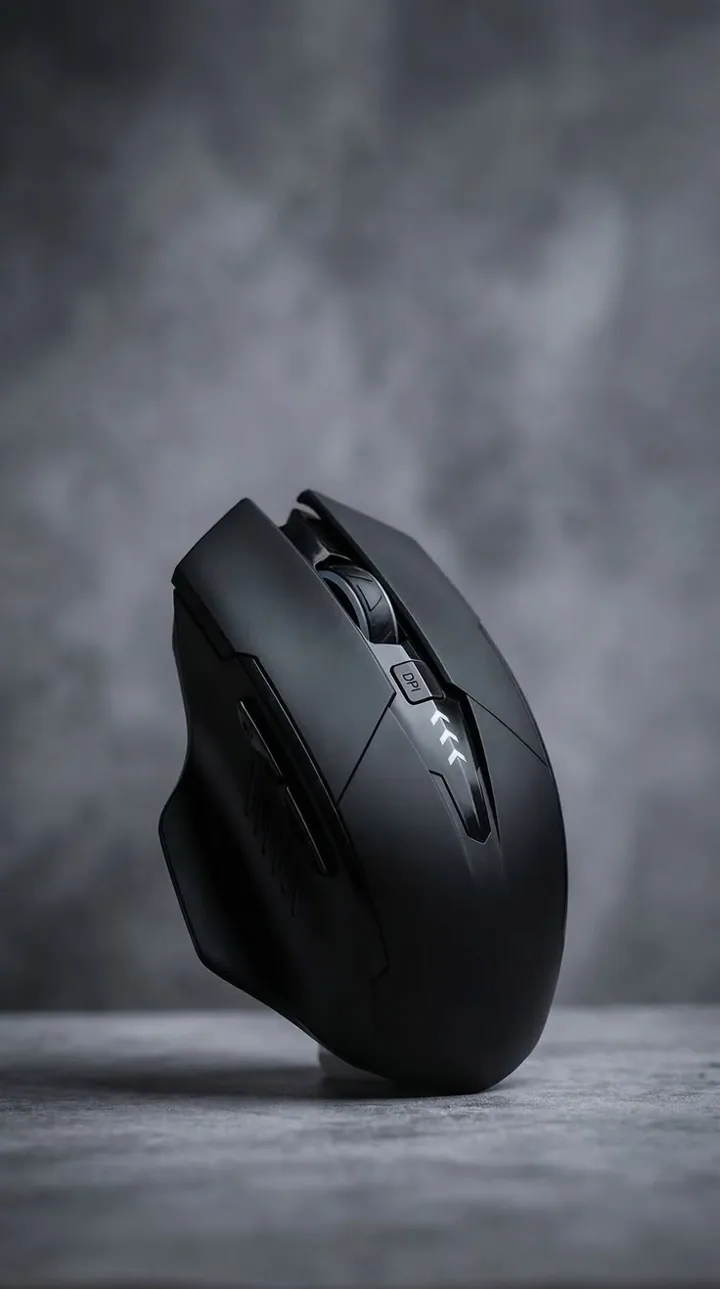
Receptor de 2.4 GHz de baixa latência, bateria de 70 dias e switches silenciosos. Feito para dias longos.
| Conexão | 2.4 GHz, BT5 |
| Bateria | 70 dias |
| Peso | 62 g |
Mantenha apenas o conteúdo principal
O Spicrawl remove o banner de cookies, os menus, os anúncios e o rodapé, e mantém o conteúdo principal.
curl -X POST https://api.spicrawl.com/v1/scrape \ -H "Authorization: Bearer spicrawl_live_…" \ -H "Content-Type: application/json" \ -d '{ "url": "https://example.com/product/1", "response_format": "markdown", "main_content_only": true }'Como funciona
- Envie uma URL para
POST /v1/scrapee escolha umresponse_format. - O Spicrawl busca a página. Ele usa primeiro uma requisição simples, ou um navegador quando você pede.
- Você recebe o resultado no corpo da resposta, com o status do próprio site em um cabeçalho.
curl -sS -D - https://api.spicrawl.com/v1/scrape \
  -H "Authorization: Bearer $SPICRAWL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://example.com/products/42", "response_format": "markdown"}'
import os, requests
r = requests.post(
"https://api.spicrawl.com/v1/scrape",
headers={"Authorization": f"Bearer {os.environ['SPICRAWL_API_KEY']}"},
json={"url": "https://example.com/products/42", "response_format": "markdown"},
timeout=120,
)
print("site status:", r.headers.get("X-Target-Status"))
print(r.text)const r = await fetch("https://api.spicrawl.com/v1/scrape", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.SPICRAWL_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({ url: "https://example.com/products/42", response_format: "markdown" }),
});
console.log("site status:", r.headers.get("X-Target-Status"));
console.log(await r.text());spicrawl scrape https://example.com/products/42 --format markdown --metaGuarde sua chave em SPICRAWL_API_KEY e nunca a escreva em código que você commita.
Formatos de saída
| Formato | Melhor para |
|---|---|
markdown | Prompts de IA, RAG e leitura. Somente o conteúdo principal por padrão. |
json | Apps: o conteúdo mais metadados, links ou campos extraídos em um único objeto. |
html | Quando você precisa da marcação da página. Este é o padrão. |
text | A menor saída, sem formatação. |
pdf | Um PDF da página renderizada. |
Veja site para Markdown para saber mais sobre a saída em Markdown.
Verifique o resultado
O status HTTP é o do Spicrawl. O que o site respondeu está em X-Target-Status. Uma chamada bem-sucedida fica assim:
HTTP/2 200
content-type: text/markdown; charset=utf-8
x-target-status: 200
x-engine: fetch
x-credits-charged: 1
cache-state: miss
Um 403 ou 503 em X-Target-Status significa que você recebeu uma página de bloqueio, e ela custa 0 crédito.
Páginas que precisam de mais
- Páginas JavaScript. Defina
js_render: truepara carregar a página antes em um navegador. Veja Renderização JavaScript. - Páginas com login. Use uma sessão para manter cookies entre requisições, para contas que são suas ou que você pode usar. Veja sessões e logins.
- Cliques e rolagem. As ações de navegador podem clicar, digitar e rolar a página antes de ela ser lida. Veja ações de navegador.
- Muitas URLs. Um job em batch aceita até 10.000 URLs em uma chamada. Veja batch.
Quanto custa
- Grátis durante o beta, sem cartão de crédito.
- Créditos por requisição bem-sucedida: 1 para uma requisição simples, 3 para renderização JavaScript, 8 para renderização em navegador completo.
- Falhas são grátis: erros, desafios de bot e páginas que respondem com erro custam 0.
- Limite cada requisição com
max_cost, para que uma chamada nunca custe mais do que você espera.
Bom saber
- Sem crawl. O Spicrawl não segue links nem descobre páginas. Você envia as URLs.
- Em breve: proxies gerenciados, modo stealth, um navegador remoto e extração a partir de um prompt em linguagem natural. Hoje você pode usar seu próprio proxy sem custo extra.
- Sua responsabilidade: busque só páginas que você tem o direito de usar. Veja nossos termos.
Perguntas frequentes
O que é uma API de web scraping?
É um serviço que busca uma página da web para você e devolve o conteúdo em uma forma que o seu código consegue usar. Você envia uma URL; ele cuida da requisição, do JavaScript e da limpeza, e devolve Markdown, JSON ou HTML.
Quanto custa a API de scraping do Spicrawl?
É grátis durante o beta, sem cartão de crédito. As requisições usam créditos: 1 para uma requisição simples, 3 para renderização JavaScript e 8 para renderização em navegador completo. Erros, desafios de bot e páginas que respondem com erro custam 0.
Ele faz scrape de páginas que precisam de JavaScript?
Sim. Defina js_render como true e a página carrega primeiro em um navegador. Comece com uma requisição simples e renderize só quando o resultado simples vier vazio.
Como sei se o site me bloqueou?
Leia o cabeçalho X-Target-Status. O status HTTP é o do Spicrawl; X-Target-Status é o que o site respondeu. Um 403 ou 503 ali significa que você recebeu uma página de bloqueio, e ela custa 0 crédito.
Ele faz crawl de um site inteiro?
Não. O Spicrawl não segue links nem descobre páginas. Envie as URLs que quer, uma por vez ou até 10.000 em uma chamada de batch.