


API di web scraping per dati puliti
Invia qualsiasi URL. Ottieni Markdown o JSON pulito, pronto per la tua app o il tuo agente AI.
Trascina sulla pagina per vedere il testo pulito che Spicrawl conserva.
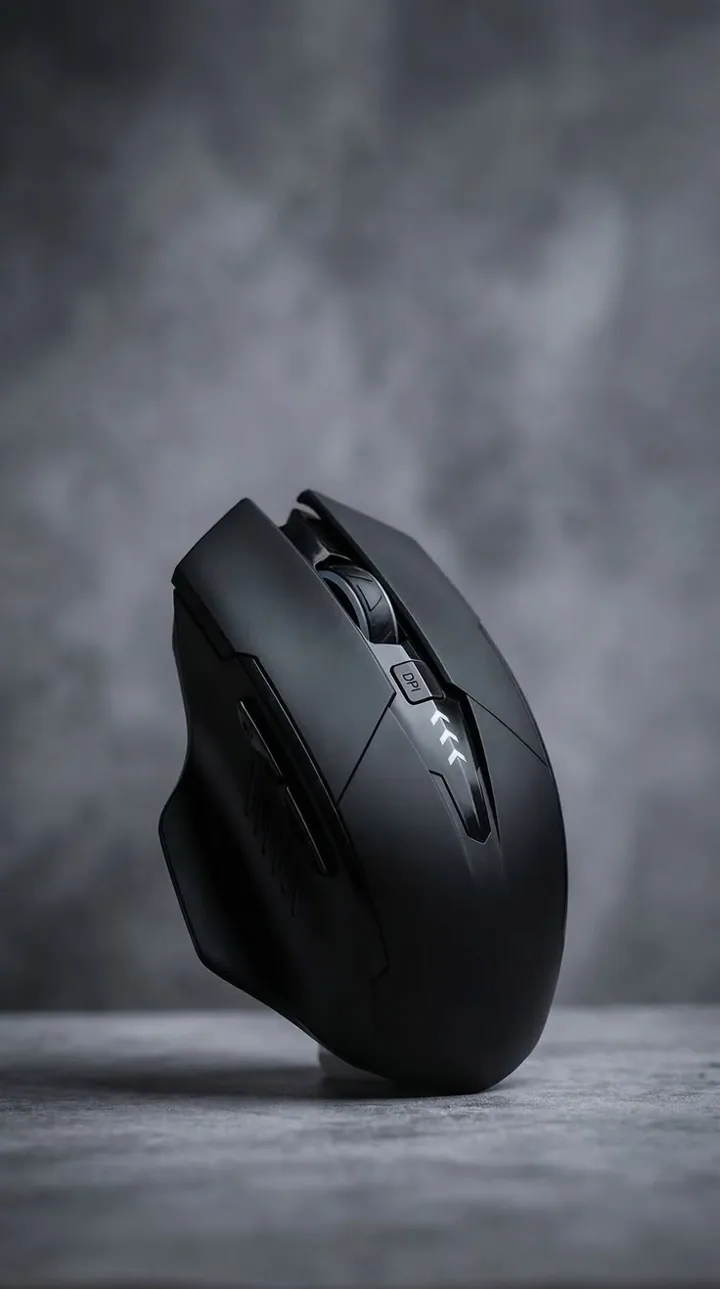
Ricevitore a bassa latenza da 2.4 GHz, 70 giorni di autonomia della batteria e switch silenziosi. Fatta per le giornate lunghe.
| Connessione | 2.4 GHz, BT5 |
| Batteria | 70 giorni |
| Peso | 62 g |
Mantieni solo il contenuto principale
Spicrawl elimina il banner dei cookie, i menu, gli annunci e il footer, e mantiene il contenuto principale.
curl -X POST https://api.spicrawl.com/v1/scrape \ -H "Authorization: Bearer spicrawl_live_…" \ -H "Content-Type: application/json" \ -d '{ "url": "https://example.com/product/1", "response_format": "markdown", "main_content_only": true }'Come funziona
- Invia un URL a
POST /v1/scrapee scegli unresponse_format. - Spicrawl recupera la pagina. Usa prima una richiesta semplice, o un browser quando lo chiedi.
- Ottieni il risultato nel corpo della risposta, con lo stato del sito in un header.
curl -sS -D - https://api.spicrawl.com/v1/scrape \
  -H "Authorization: Bearer $SPICRAWL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://example.com/products/42", "response_format": "markdown"}'
import os, requests
r = requests.post(
"https://api.spicrawl.com/v1/scrape",
headers={"Authorization": f"Bearer {os.environ['SPICRAWL_API_KEY']}"},
json={"url": "https://example.com/products/42", "response_format": "markdown"},
timeout=120,
)
print("site status:", r.headers.get("X-Target-Status"))
print(r.text)const r = await fetch("https://api.spicrawl.com/v1/scrape", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.SPICRAWL_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({ url: "https://example.com/products/42", response_format: "markdown" }),
});
console.log("site status:", r.headers.get("X-Target-Status"));
console.log(await r.text());spicrawl scrape https://example.com/products/42 --format markdown --metaTieni la chiave in SPICRAWL_API_KEY e non scriverla mai nel codice che committi.
Formati di output
| Formato | Ideale per |
|---|---|
markdown | Prompt AI, RAG e lettura. Per impostazione predefinita solo il contenuto principale. |
json | App: il contenuto più metadati, link o campi estratti in un solo oggetto. |
html | Quando ti serve il markup della pagina. È il predefinito. |
text | L’output più piccolo, senza formattazione. |
pdf | Un PDF della pagina renderizzata. |
Vedi sito web in Markdown per saperne di più sull’output Markdown.
Controlla il risultato
Lo stato HTTP è quello di Spicrawl. Ciò che ha risposto il sito è in X-Target-Status. Una chiamata riuscita appare così:
HTTP/2 200
content-type: text/markdown; charset=utf-8
x-target-status: 200
x-engine: fetch
x-credits-charged: 1
cache-state: miss
Un 403 o 503 in X-Target-Status significa che hai ricevuto una pagina di blocco, e costa 0 crediti.
Pagine che richiedono di più
- Pagine JavaScript. Imposta
js_render: trueper caricare prima la pagina in un browser. Vedi Rendering JavaScript. - Pagine con login. Usa una sessione per mantenere i cookie tra le richieste, per account di tua proprietà o che sei autorizzato a usare. Vedi sessioni e login.
- Click e scorrimento. Le azioni del browser possono cliccare, digitare e scorrere prima che la pagina venga letta. Vedi azioni del browser.
- Molti URL. Un batch job accetta fino a 10.000 URL in una sola chiamata. Vedi batch.
Quanto costa
- Gratis durante la beta, senza carta di credito.
- Crediti per richiesta riuscita: 1 per una richiesta semplice, 3 per il rendering JavaScript, 8 per il rendering con browser completo.
- I fallimenti sono gratuiti: errori, challenge anti-bot e pagine che rispondono con un errore costano 0.
- Limita ogni richiesta con
max_cost, così una chiamata non costa mai più del previsto.
Da sapere
- Nessun crawling. Spicrawl non segue link né scopre pagine. Gli URL li invii tu.
- In arrivo: proxy gestiti, modalità stealth, un browser remoto ed estrazione da un prompt in linguaggio naturale. Oggi puoi usare il tuo proxy senza costi extra.
- La tua responsabilità: recupera solo pagine che hai il diritto di usare. Vedi i nostri termini.
Domande frequenti
Che cos’è un’API di web scraping?
È un servizio che recupera una pagina web per te e ne restituisce il contenuto in una forma che il tuo codice può usare. Invii un URL; lui gestisce la richiesta, il JavaScript e la pulizia, e restituisce Markdown, JSON o HTML.
Quanto costa l’API di scraping di Spicrawl?
È gratis durante la beta, senza carta di credito. Le richieste usano crediti: 1 per una richiesta semplice, 3 per il rendering JavaScript e 8 per il rendering con browser completo. Errori, challenge anti-bot e pagine che rispondono con un errore costano 0.
Può fare lo scraping di pagine che richiedono JavaScript?
Sì. Imposta js_render su true e la pagina viene caricata prima in un browser. Inizia con una richiesta semplice e fai il rendering solo quando il risultato semplice è vuoto.
Come capisco se il sito mi ha bloccato?
Leggi l’header X-Target-Status. Lo stato HTTP è quello di Spicrawl; X-Target-Status è ciò che ha risposto il sito. Un 403 o 503 lì significa che hai ricevuto una pagina di blocco, e costa 0 crediti.
Può fare il crawl di un intero sito?
No. Spicrawl non segue i link né scopre pagine. Invia gli URL che vuoi, uno alla volta o fino a 10.000 in una sola chiamata batch.