


साफ़ data के लिए Web scraping API
कोई भी URL भेजें। अपने app या AI agent के लिए तैयार साफ़ Markdown या JSON वापस पाएँ।
Spicrawl जो साफ़ text रखता है उसे देखने के लिए page पर drag करें।
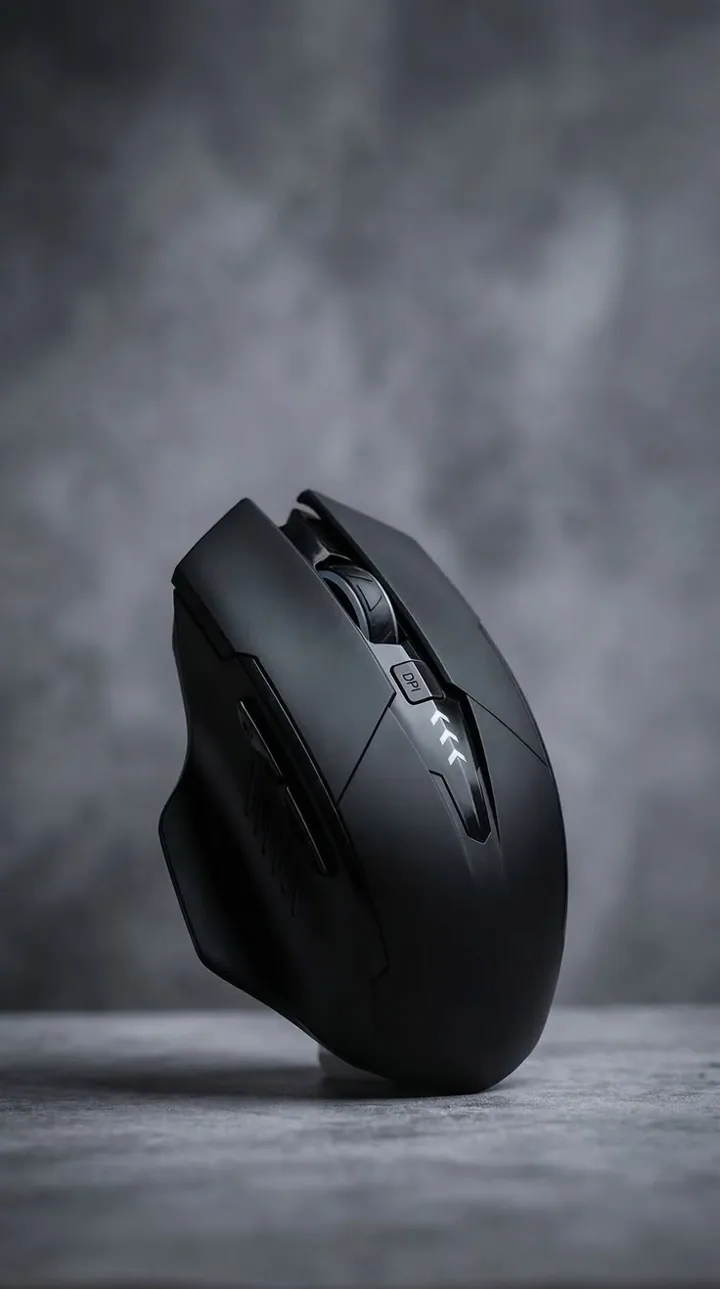
कम-latency 2.4 GHz receiver, 70 दिन की battery life और silent switches। लंबे दिनों के लिए बना।
| Connection | 2.4 GHz, BT5 |
| Battery | 70 दिन |
| Weight | 62 g |
सिर्फ़ main content रखें
Spicrawl cookie banner, menus, ads और footer हटा देता है, और main content रखता है।
curl -X POST https://api.spicrawl.com/v1/scrape \ -H "Authorization: Bearer spicrawl_live_…" \ -H "Content-Type: application/json" \ -d '{ "url": "https://example.com/product/1", "response_format": "markdown", "main_content_only": true }'यह कैसे काम करता है
- URL भेजें
POST /v1/scrapeपर और एकresponse_formatचुनें। - Spicrawl page fetch करता है। यह पहले plain request इस्तेमाल करता है, या जब आप कहें तो browser।
- आपको result मिलता है response body में, site का अपना status एक header में।
curl -sS -D - https://api.spicrawl.com/v1/scrape \
  -H "Authorization: Bearer $SPICRAWL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://example.com/products/42", "response_format": "markdown"}'
import os, requests
r = requests.post(
"https://api.spicrawl.com/v1/scrape",
headers={"Authorization": f"Bearer {os.environ['SPICRAWL_API_KEY']}"},
json={"url": "https://example.com/products/42", "response_format": "markdown"},
timeout=120,
)
print("site status:", r.headers.get("X-Target-Status"))
print(r.text)const r = await fetch("https://api.spicrawl.com/v1/scrape", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.SPICRAWL_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({ url: "https://example.com/products/42", response_format: "markdown" }),
});
console.log("site status:", r.headers.get("X-Target-Status"));
console.log(await r.text());spicrawl scrape https://example.com/products/42 --format markdown --metaअपनी key SPICRAWL_API_KEY में रखें और उसे कभी उस code में न लिखें जिसे आप commit करते हैं।
Output formats
| Format | इसके लिए सबसे अच्छा |
|---|---|
markdown | AI prompts, RAG और पढ़ने के लिए। Default रूप से सिर्फ़ main content। |
json | Apps: content के साथ metadata, links या extracted fields, एक object में। |
html | जब आपको page का markup चाहिए। यह default है। |
text | सबसे छोटा output, बिना formatting के। |
pdf | rendered page का PDF। |
Markdown output के बारे में और जानने के लिए website से Markdown देखें।
Result जाँचें
HTTP status Spicrawl का है। Site ने क्या जवाब दिया, यह X-Target-Status में है। सफल call ऐसी दिखती है:
HTTP/2 200
content-type: text/markdown; charset=utf-8
x-target-status: 200
x-engine: fetch
x-credits-charged: 1
cache-state: miss
X-Target-Status में 403 या 503 का मतलब है कि आपको block page मिला, और इसकी कीमत 0 credits है।
जिन pages को और चाहिए
- JavaScript pages। Page को पहले browser में load करने के लिए
js_render: trueset करें। देखें JavaScript rendering। - Logged-in pages। उन accounts के लिए जो आपके हैं या जिन्हें आप इस्तेमाल कर सकते हैं, requests के बीच cookies रखने के लिए session इस्तेमाल करें। देखें sessions और logins।
- Clicks और scrolling। Browser actions page पढ़ने से पहले click, type और scroll कर सकते हैं। देखें browser actions।
- कई URLs। एक batch job एक call में 10,000 URLs तक लेती है। देखें batch।
इसकी कीमत क्या है
- Beta के दौरान free, credit card के बिना।
- प्रति सफल request credits: plain request के लिए 1, JavaScript rendering के लिए 3, full-browser rendering के लिए 8।
- Failures free हैं: errors, bot challenges और error देने वाले pages की कीमत 0 है।
- हर request की सीमा तय करें
max_costके साथ, ताकि कोई call आपकी उम्मीद से ज़्यादा खर्च न करे।
जानने लायक बातें
- Crawling नहीं। Spicrawl links follow नहीं करता और pages discover नहीं करता। URLs आप भेजते हैं।
- जल्द आ रहा है: managed proxies, stealth mode, एक remote browser और एक plain-language prompt से extraction। आज आप बिना अतिरिक्त कीमत के अपना proxy ला सकते हैं।
- आपकी ज़िम्मेदारी: सिर्फ़ वही pages fetch करें जिन्हें इस्तेमाल करने का आपको अधिकार है। हमारे terms देखें।
अक्सर पूछे जाने वाले सवाल
Web scraping API क्या है?
यह एक service है जो आपके लिए web page fetch करती है और उसका content ऐसे रूप में लौटाती है जिसे आपका code इस्तेमाल कर सके। आप एक URL भेजते हैं; यह request, JavaScript और clean-up संभालती है, और Markdown, JSON या HTML लौटाती है।
Spicrawl scraping API की कीमत कितनी है?
Beta के दौरान यह free है, credit card नहीं चाहिए। Requests credits इस्तेमाल करती हैं: plain request के लिए 1, JavaScript rendering के लिए 3 और full-browser rendering के लिए 8। Errors, bot challenges और error देने वाले pages पर 0 लगता है।
क्या यह उन pages को scrape कर सकता है जिन्हें JavaScript चाहिए?
हाँ। js_render को true सेट करें और page पहले browser में load होता है। Plain request से शुरू करें और तभी render करें जब plain result खाली हो।
मुझे कैसे पता चले कि site ने मुझे block किया?
X-Target-Status header पढ़ें। HTTP status Spicrawl का है; X-Target-Status वह है जो site ने जवाब दिया। वहाँ 403 या 503 का मतलब है कि आपको block page मिला, और इसकी कीमत 0 credits है।
क्या यह पूरी website crawl कर सकता है?
नहीं। Spicrawl links follow नहीं करता और pages नहीं ढूँढता। अपने चाहे URLs भेजें, एक-एक करके या एक batch call में 10,000 तक।