


API de web scraping para datos limpios
Envía cualquier URL. Recibe Markdown o JSON limpio, listo para tu app o agente de IA.
Arrastra por la página para ver el texto limpio que conserva Spicrawl.
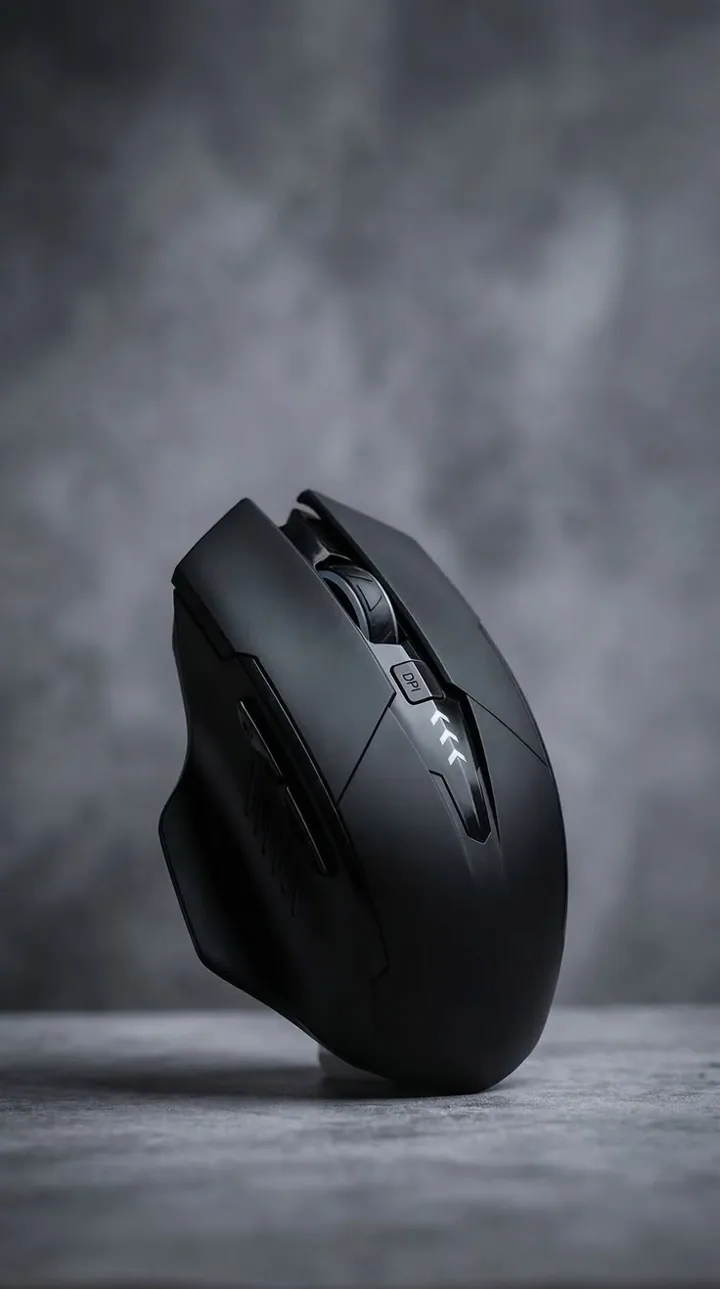
Receptor de 2,4 GHz de baja latencia, 70 días de batería e interruptores silenciosos. Hecho para jornadas largas.
| Conexión | 2,4 GHz, BT5 |
| Batería | 70 días |
| Peso | 62 g |
Conserva solo el contenido principal
Spicrawl descarta el banner de cookies, los menús, los anuncios y el pie de página, y conserva el contenido principal.
curl -X POST https://api.spicrawl.com/v1/scrape \ -H "Authorization: Bearer spicrawl_live_…" \ -H "Content-Type: application/json" \ -d '{ "url": "https://example.com/product/1", "response_format": "markdown", "main_content_only": true }'Cómo funciona
- Envía una URL a
POST /v1/scrapey elige unresponse_format. - Spicrawl obtiene la página. Usa primero una solicitud simple, o un navegador cuando lo pides.
- Recibes el resultado en el cuerpo de la respuesta, con el estado propio del sitio en un encabezado.
curl -sS -D - https://api.spicrawl.com/v1/scrape \
  -H "Authorization: Bearer $SPICRAWL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://example.com/products/42", "response_format": "markdown"}'
import os, requests
r = requests.post(
"https://api.spicrawl.com/v1/scrape",
headers={"Authorization": f"Bearer {os.environ['SPICRAWL_API_KEY']}"},
json={"url": "https://example.com/products/42", "response_format": "markdown"},
timeout=120,
)
print("site status:", r.headers.get("X-Target-Status"))
print(r.text)const r = await fetch("https://api.spicrawl.com/v1/scrape", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.SPICRAWL_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({ url: "https://example.com/products/42", response_format: "markdown" }),
});
console.log("site status:", r.headers.get("X-Target-Status"));
console.log(await r.text());spicrawl scrape https://example.com/products/42 --format markdown --metaGuarda tu clave en SPICRAWL_API_KEY y nunca la escribas en código que confirmes en el repositorio.
Formatos de salida
| Formato | Ideal para |
|---|---|
markdown | Para prompts de IA, RAG y lectura. Por defecto, solo el contenido principal. |
json | Apps: el contenido más metadatos, enlaces o campos extraídos en un solo objeto. |
html | Cuando necesitas el marcado de la página. Es lo predeterminado. |
text | La salida más pequeña, sin formato. |
pdf | Un PDF de la página renderizada. |
Consulta sitio web a Markdown para saber más sobre la salida en Markdown.
Revisa el resultado
El estado HTTP es el de Spicrawl. Lo que respondió el sitio está en X-Target-Status. Una llamada correcta se ve así:
HTTP/2 200
content-type: text/markdown; charset=utf-8
x-target-status: 200
x-engine: fetch
x-credits-charged: 1
cache-state: miss
Un 403 o 503 en X-Target-Status significa que recibiste una página de bloqueo, y cuesta 0 créditos.
Páginas que necesitan más
- Páginas con JavaScript. Configura
js_render: truepara cargar primero la página en un navegador. Consulta Renderizado de JavaScript. - Páginas con login. Usa una sesión para conservar las cookies entre solicitudes, para cuentas que sean tuyas o que puedas usar. Consulta sesiones y logins.
- Clics y desplazamiento. Las acciones del navegador pueden hacer clic, escribir y desplazarse antes de leer la página. Consulta acciones del navegador.
- Muchas URL. Un trabajo batch admite hasta 10.000 URL en una llamada. Consulta batch.
Cuánto cuesta
- Gratis durante la beta, sin tarjeta de crédito.
- Créditos por solicitud correcta: 1 para una solicitud simple, 3 para renderizado de JavaScript, 8 para renderizado con navegador completo.
- Los fallos son gratis: los errores, los desafíos de bots y las páginas que responden con un error cuestan 0.
- Limita cada solicitud con
max_cost, así una llamada nunca cuesta más de lo que esperas.
Conviene saber
- No rastrea. Spicrawl no sigue enlaces ni descubre páginas. Tú envías las URL.
- Próximamente: proxies gestionados, modo sigiloso, un navegador remoto y extracción a partir de un prompt en lenguaje natural. Hoy puedes usar tu propio proxy sin coste extra.
- Tu responsabilidad: solo obtén páginas que tengas derecho a usar. Consulta nuestros términos.
Preguntas frecuentes
¿Qué es una API de web scraping?
Es un servicio que obtiene una página web por ti y devuelve su contenido en una forma que tu código puede usar. Tú envías una URL; él se encarga de la solicitud, el JavaScript y la limpieza, y devuelve Markdown, JSON o HTML.
¿Cuánto cuesta la API de scraping de Spicrawl?
Es gratis durante la beta, sin tarjeta de crédito. Las solicitudes usan créditos: 1 por una solicitud simple, 3 por renderizado con JavaScript y 8 por renderizado con navegador completo. Los errores, los desafíos de bot y las páginas que responden con un error cuestan 0.
¿Puede hacer scraping de páginas que necesitan JavaScript?
Sí. Configura js_render en true y la página se carga primero en un navegador. Empieza con una solicitud simple y renderiza solo cuando el resultado simple esté vacío.
¿Cómo sé si el sitio me ha bloqueado?
Lee el encabezado X-Target-Status. El estado HTTP es el de Spicrawl; X-Target-Status es lo que respondió el sitio. Un 403 o 503 ahí significa que recibiste una página de bloqueo, y cuesta 0 créditos.
¿Puede rastrear un sitio web completo?
No. Spicrawl no sigue enlaces ni descubre páginas. Envía las URL que quieres, una a una o hasta 10.000 en una llamada batch.