


API de web scraping pour des données propres
Envoyez n’importe quelle URL. Récupérez du Markdown ou du JSON propre, prêt pour votre application ou votre agent IA.
Faites glisser sur la page pour voir le texte propre que Spicrawl conserve.
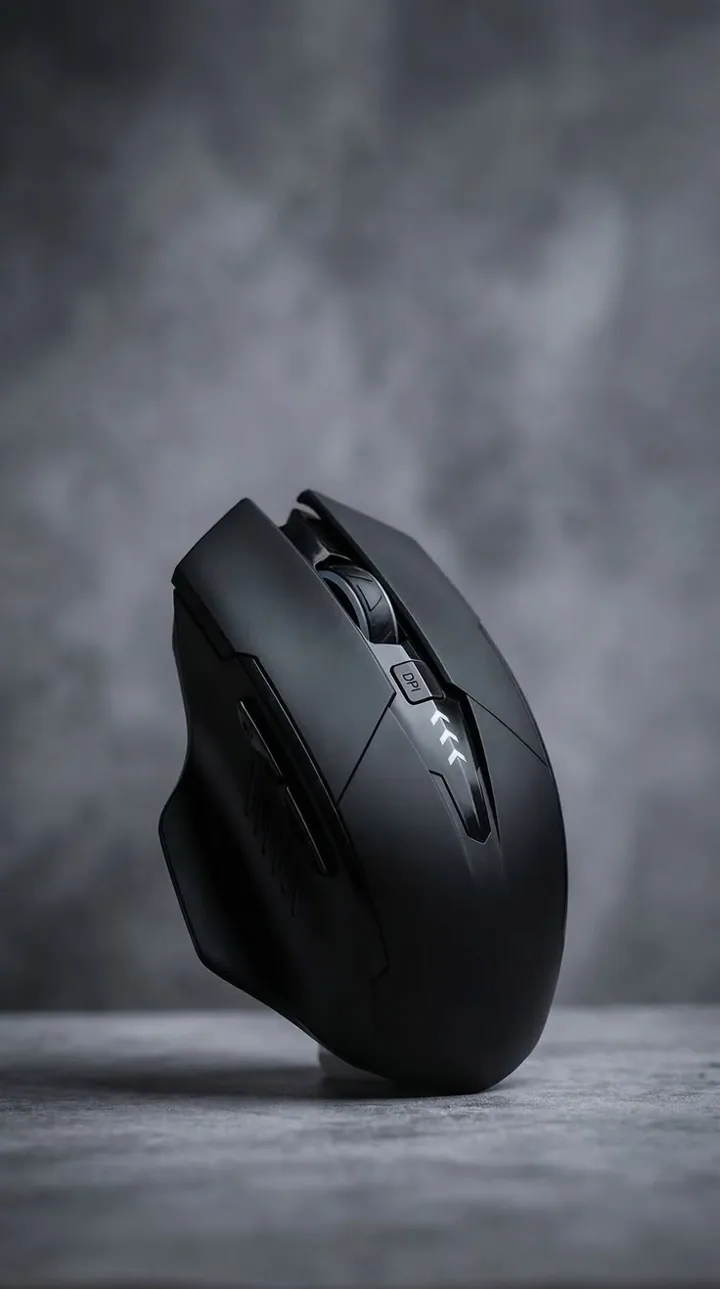
Récepteur 2,4 GHz à faible latence, 70 jours d’autonomie et interrupteurs silencieux. Conçu pour les longues journées.
| Connexion | 2.4 GHz, BT5 |
| Batterie | 70 jours |
| Poids | 62 g |
Ne garder que le contenu principal
Spicrawl retire la bannière de cookies, les menus, les publicités et le pied de page, et garde le contenu principal.
curl -X POST https://api.spicrawl.com/v1/scrape \ -H "Authorization: Bearer spicrawl_live_…" \ -H "Content-Type: application/json" \ -d '{ "url": "https://example.com/product/1", "response_format": "markdown", "main_content_only": true }'Comment ça marche
- Envoyer une URL à
POST /v1/scrapeet choisissez unresponse_format. - Spicrawl récupère la page. Il utilise d’abord une requête simple, ou un navigateur si vous en demandez un.
- Vous récupérez le résultat dans le corps de la réponse, avec le statut propre au site dans un en-tête.
curl -sS -D - https://api.spicrawl.com/v1/scrape \
  -H "Authorization: Bearer $SPICRAWL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://example.com/products/42", "response_format": "markdown"}'
import os, requests
r = requests.post(
"https://api.spicrawl.com/v1/scrape",
headers={"Authorization": f"Bearer {os.environ['SPICRAWL_API_KEY']}"},
json={"url": "https://example.com/products/42", "response_format": "markdown"},
timeout=120,
)
print("site status:", r.headers.get("X-Target-Status"))
print(r.text)const r = await fetch("https://api.spicrawl.com/v1/scrape", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.SPICRAWL_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({ url: "https://example.com/products/42", response_format: "markdown" }),
});
console.log("site status:", r.headers.get("X-Target-Status"));
console.log(await r.text());spicrawl scrape https://example.com/products/42 --format markdown --metaGardez votre clé dans SPICRAWL_API_KEY et ne l’écrivez jamais dans du code que vous commitez.
Formats de sortie
| Format | Idéal pour |
|---|---|
markdown | Prompts IA, RAG et lecture. Contenu principal uniquement par défaut. |
json | Applications : le contenu, plus les métadonnées, les liens ou les champs extraits, dans un seul objet. |
html | Quand vous avez besoin du balisage de la page. C’est la valeur par défaut. |
text | La sortie la plus petite, sans mise en forme. |
pdf | Un PDF de la page rendue. |
Voir site web en Markdown pour en savoir plus sur la sortie Markdown.
Vérifier le résultat
Le statut HTTP est celui de Spicrawl. Ce que le site a répondu se trouve dans X-Target-Status. Un appel réussi ressemble à ceci :
HTTP/2 200
content-type: text/markdown; charset=utf-8
x-target-status: 200
x-engine: fetch
x-credits-charged: 1
cache-state: miss
Un 403 ou un 503 dans X-Target-Status signifie que vous avez reçu une page de blocage, et cela coûte 0 crédit.
Pages qui demandent plus
- Pages JavaScript. Définissez
js_render: truepour charger d’abord la page dans un navigateur. Voir Rendu JavaScript. - Pages avec connexion. Utilisez une session pour conserver les cookies entre les requêtes, pour des comptes qui vous appartiennent ou que vous avez le droit d’utiliser. Voir sessions et connexions.
- Clics et défilement. Les actions de navigateur peuvent cliquer, saisir et faire défiler avant la lecture de la page. Voir actions de navigateur.
- De nombreuses URL. Un job batch accepte jusqu’à 10 000 URL en un seul appel. Voir batch.
Ce que ça coûte
- Gratuit pendant la bêta, sans carte bancaire.
- Crédits par requête réussie : 1 pour une requête simple, 3 pour le rendu JavaScript, 8 pour le rendu navigateur complet.
- Les échecs sont gratuits : les erreurs, les défis anti-bot et les pages qui répondent par une erreur coûtent 0.
- Plafonner chaque requête avec
max_cost, pour qu’un appel ne coûte jamais plus que prévu.
Bon à savoir
- Pas de crawl. Spicrawl ne suit pas les liens et ne découvre pas de pages. Vous envoyez les URL.
- Bientôt disponible : proxys gérés, mode furtif, navigateur distant et extraction à partir d’un prompt en langage naturel. Aujourd’hui, vous pouvez apporter votre propre proxy sans supplément.
- Votre responsabilité : ne récupérez que les pages que vous avez le droit d’utiliser. Consultez nos conditions.
Questions fréquentes
Qu’est-ce qu’une API de web scraping ?
C’est un service qui récupère une page web pour vous et renvoie son contenu sous une forme que votre code peut utiliser. Vous envoyez une URL ; il gère la requête, le JavaScript et le nettoyage, puis renvoie du Markdown, du JSON ou du HTML.
Combien coûte l’API de scraping Spicrawl ?
C’est gratuit pendant la bêta, sans carte bancaire. Les requêtes utilisent des crédits : 1 pour une requête simple, 3 pour le rendu JavaScript et 8 pour le rendu navigateur complet. Les erreurs, les défis anti-bot et les pages qui répondent par une erreur coûtent 0.
Peut-il scraper des pages qui ont besoin de JavaScript ?
Oui. Définissez js_render sur true et la page se charge d’abord dans un navigateur. Commencez par une requête simple et ne rendez que lorsque le résultat simple est vide.
Comment savoir si le site m’a bloqué ?
Lisez l’en-tête X-Target-Status. Le statut HTTP est celui de Spicrawl ; X-Target-Status est ce que le site a répondu. Un 403 ou un 503 à cet endroit signifie que vous avez reçu une page de blocage, et cela coûte 0 crédit.
Peut-il crawler un site entier ?
Non. Spicrawl ne suit pas les liens et ne découvre pas de pages. Envoyez les URL voulues, une par une ou jusqu’à 10 000 en un seul appel batch.