


API do web scrapingu dla czystych danych
Wyślij dowolny adres URL. Dostań czysty Markdown lub JSON, gotowy dla Twojej aplikacji lub agenta AI.
Przeciągnij po stronie, aby zobaczyć czysty tekst, który zachowuje Spicrawl.
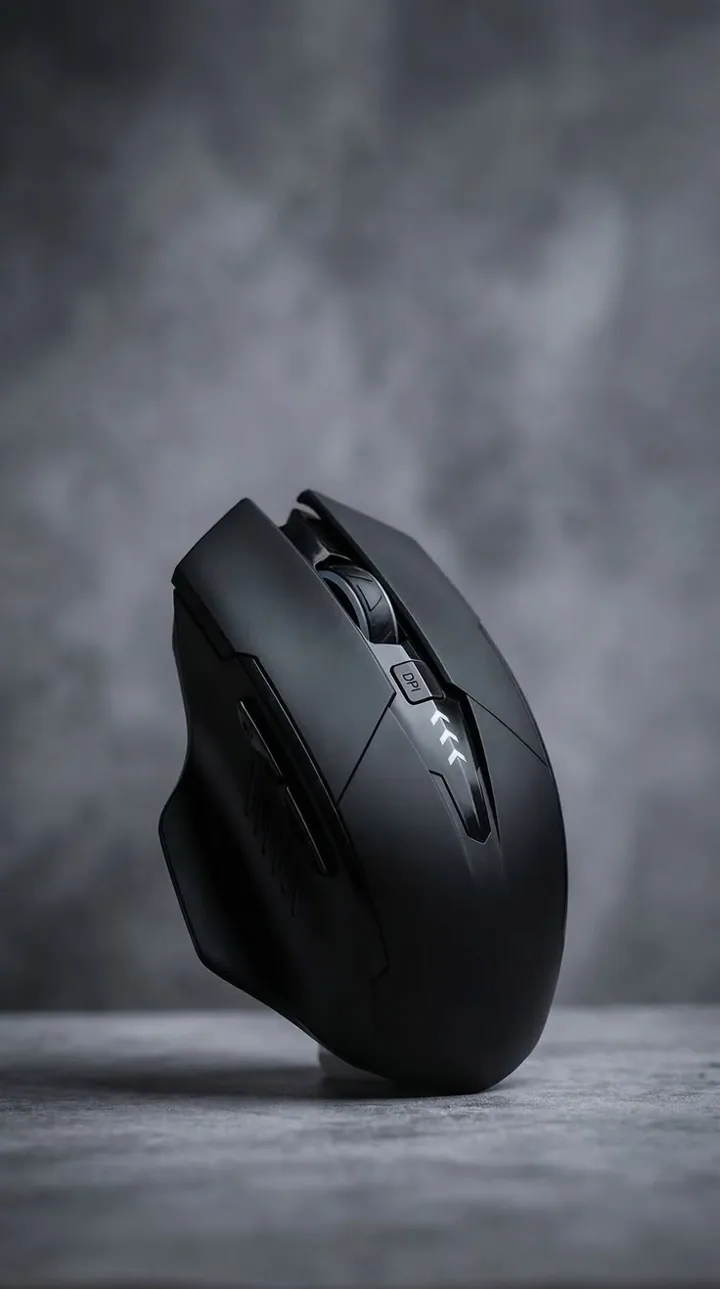
Odbiornik 2.4 GHz o niskim opóźnieniu, 70 dni pracy na baterii i ciche przełączniki. Stworzona na długie dni.
| Połączenie | 2.4 GHz, BT5 |
| Bateria | 70 dni |
| Waga | 62 g |
Zachowaj tylko główną treść
Spicrawl usuwa baner cookie, menu, reklamy i stopkę, a zachowuje główną treść.
curl -X POST https://api.spicrawl.com/v1/scrape \ -H "Authorization: Bearer spicrawl_live_…" \ -H "Content-Type: application/json" \ -d '{ "url": "https://example.com/product/1", "response_format": "markdown", "main_content_only": true }'Jak to działa
- Wyślij adres URL na
POST /v1/scrapei wybierzresponse_format. - Spicrawl pobiera stronę. Najpierw używa zwykłego żądania albo przeglądarki, gdy o nią poprosisz.
- Dostajesz wynik w treści odpowiedzi, a status samej witryny w nagłówku.
curl -sS -D - https://api.spicrawl.com/v1/scrape \
  -H "Authorization: Bearer $SPICRAWL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://example.com/products/42", "response_format": "markdown"}'
import os, requests
r = requests.post(
"https://api.spicrawl.com/v1/scrape",
headers={"Authorization": f"Bearer {os.environ['SPICRAWL_API_KEY']}"},
json={"url": "https://example.com/products/42", "response_format": "markdown"},
timeout=120,
)
print("site status:", r.headers.get("X-Target-Status"))
print(r.text)const r = await fetch("https://api.spicrawl.com/v1/scrape", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.SPICRAWL_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({ url: "https://example.com/products/42", response_format: "markdown" }),
});
console.log("site status:", r.headers.get("X-Target-Status"));
console.log(await r.text());spicrawl scrape https://example.com/products/42 --format markdown --metaTrzymaj klucz w SPICRAWL_API_KEY i nigdy nie wpisuj go w kodzie, który commitujesz.
Formaty wyjściowe
| Format | Najlepsze do |
|---|---|
markdown | Prompty AI, RAG i czytanie. Domyślnie tylko główna treść. |
json | Aplikacje: treść plus metadane, linki lub wyodrębnione pola w jednym obiekcie. |
html | Gdy potrzebujesz kodu strony. To jest domyślne. |
text | Najmniejszy wynik, bez formatowania. |
pdf | PDF wyrenderowanej strony. |
Zobacz strona na Markdown, aby dowiedzieć się więcej o wyjściu w Markdown.
Sprawdź wynik
Status HTTP pochodzi ze Spicrawl. To, co odpowiedziała witryna, jest w X-Target-Status. Udane wywołanie wygląda tak:
HTTP/2 200
content-type: text/markdown; charset=utf-8
x-target-status: 200
x-engine: fetch
x-credits-charged: 1
cache-state: miss
403 lub 503 w X-Target-Status oznacza, że dostałeś stronę z blokadą, a to kosztuje 0 kredytów.
Strony, które potrzebują więcej
- Strony JavaScript. Ustaw
js_render: true, aby najpierw załadować stronę w przeglądarce. Zobacz Renderowanie JavaScriptu. - Strony wymagające logowania. Użyj sesji, aby zachować ciasteczka między żądaniami, dla kont, którymi zarządzasz lub których możesz używać. Zobacz sesje i logowanie.
- Kliknięcia i przewijanie. Akcje w przeglądarce mogą klikać, wpisywać i przewijać, zanim strona zostanie odczytana. Zobacz akcje w przeglądarce.
- Wiele adresów URL. Zadanie batch przyjmuje do 10,000 adresów URL w jednym wywołaniu. Zobacz batch.
Ile kosztuje
- Bezpłatne w becie, bez karty kredytowej.
- Kredyty za udane żądanie: 1 za zwykłe żądanie, 3 za renderowanie JavaScriptu, 8 za renderowanie w pełnej przeglądarce.
- Błędy są darmowe: błędy, zabezpieczenia anty-bot i strony odpowiadające błędem kosztują 0.
- Ogranicz każde żądanie za pomocą
max_cost, dzięki czemu wywołanie nigdy nie kosztuje więcej, niż się spodziewasz.
Warto wiedzieć
- Bez crawlowania. Spicrawl nie podąża za linkami ani nie wyszukuje stron. Adresy URL wysyłasz Ty.
- Wkrótce: zarządzane proxy, tryb stealth, zdalna przeglądarka i ekstrakcja z promptu w zwykłym języku. Dziś możesz użyć własnego proxy bez dodatkowych kosztów.
- Twoja odpowiedzialność: pobieraj tylko strony, do których masz prawo. Zobacz nasz regulamin.
Najczęściej zadawane pytania
Czym jest API do web scrapingu?
To usługa, która pobiera za Ciebie stronę internetową i zwraca jej treść w postaci, której może użyć Twój kod. Wysyłasz adres URL; ona zajmuje się żądaniem, JavaScriptem i czyszczeniem, a zwraca Markdown, JSON lub HTML.
Ile kosztuje API Spicrawl do web scrapingu?
W becie jest bezpłatny, bez karty kredytowej. Żądania zużywają kredyty: 1 za zwykłe żądanie, 3 za renderowanie JavaScriptu i 8 za renderowanie w pełnej przeglądarce. Błędy, zabezpieczenia anty-bot i strony odpowiadające błędem kosztują 0.
Czy potrafi scrapować strony wymagające JavaScriptu?
Tak. Ustaw js_render na true, a strona najpierw załaduje się w przeglądarce. Zacznij od zwykłego żądania i renderuj tylko wtedy, gdy zwykły wynik jest pusty.
Skąd mam wiedzieć, że strona mnie zablokowała?
Sprawdź nagłówek X-Target-Status. Status HTTP pochodzi ze Spicrawl; X-Target-Status to to, co odpowiedziała witryna. 403 lub 503 tam oznacza, że dostałeś stronę z blokadą, a to kosztuje 0 kredytów.
Czy potrafi crawlować całą stronę internetową?
Nie. Spicrawl nie podąża za linkami ani nie odkrywa stron. Wyślij adresy URL, które chcesz, pojedynczo lub do 10,000 w jednym wywołaniu batch.